讓你的品牌,
成為 AI 給出的答案。

品牌進軍東南亞,買家會直接問 ChatGPT、Gemini、Perplexity、Claude 和 Google AI 概覽。看清它們怎麼介紹你,又讀了哪些來源。

免費預覽掃描 · ChatGPT 與 Google AI 概覽真實回答 · 無需信用卡
在五個 AI 引擎上測量
ChatGPT Gemini Perplexity Claude Google AI 概覽
1,992則帶引用的 AI 回答,是我們 9 月在越南讀完的,涵蓋 6 個行業的 10 個品牌面板。2026 年 9 月 · 4 個引擎
0.7%買家還不認識品牌時,AI 讀到的來源裡只有這麼多來自品牌官網。12 個品牌 · 3,011 則帶引用回答 · 2026 年 6–10 月
19.2%的帶引用回答引用了 vnexpress.net,它是 AI 在越南最依賴的來源。1,992 則中的 382 則 · 2026 年 9 月
MemeCMO — 我們不猜測 AI 怎麼描述你。我們測量它、修正它,並證明它確實改變了。
五個引擎 · 十個 AI 代理 · 一份公開的測量標準
測量 · 五個引擎 · 一個凍結面板

用買家會問的問題去問 AI。每週都問同一組。

每次掃描都把買家真正會問的問題——用他們的語言、涵蓋每個購買階段——拿去問 ChatGPT、Gemini、Perplexity、Claude,以及即時的 Google AI 概覽頁面。面板保持凍結,因此分數的變化反映的是 AI 的變化,而不是測試本身的變化。

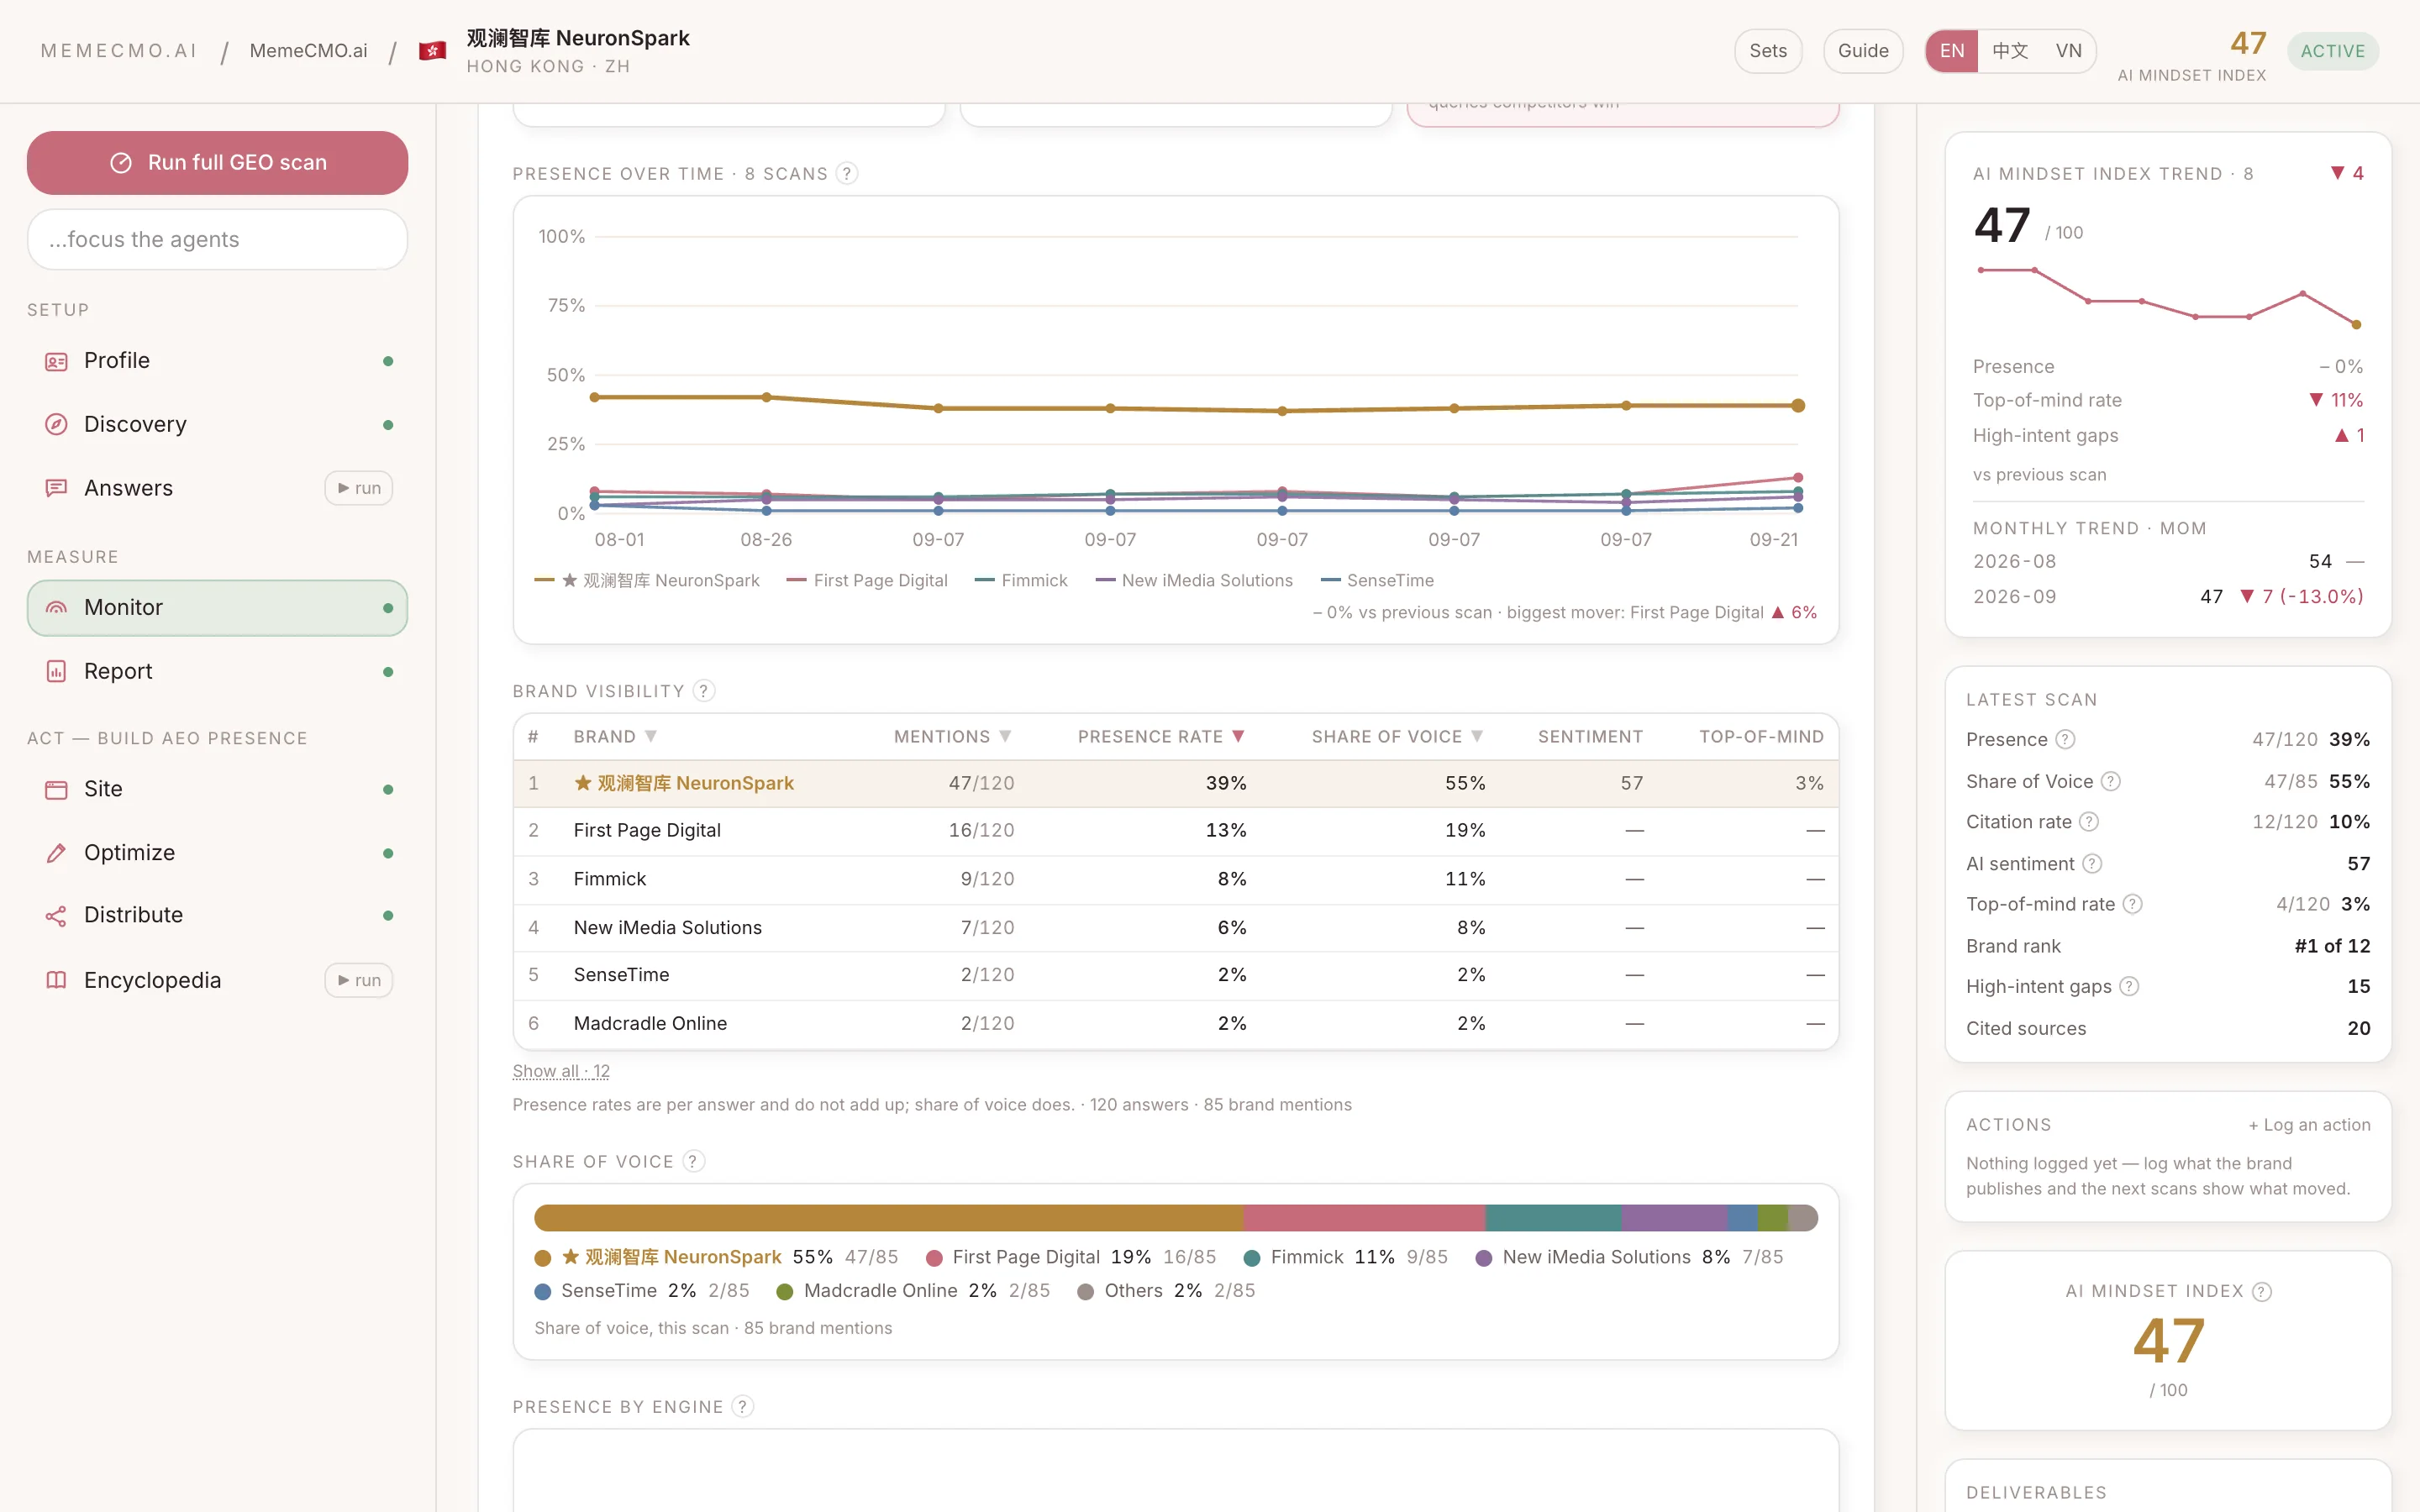
  • 出現率、聲量佔比、顯著度、情感與引用——每個比率都附上分子與分母
  • 每個引擎分開呈現:同一個品牌可能在某個引擎上領先,在下一個引擎上卻完全缺席
  • 每個數字都能點開背後的完整回答,以及引擎引用的頁面
app.memecmo.ai
MemeCMO 監測儀表板:出現率走勢、品牌可見度表、各引擎出現率
來源 · AI 去哪裡找資料

AI 讀的頁面,我們也讀。

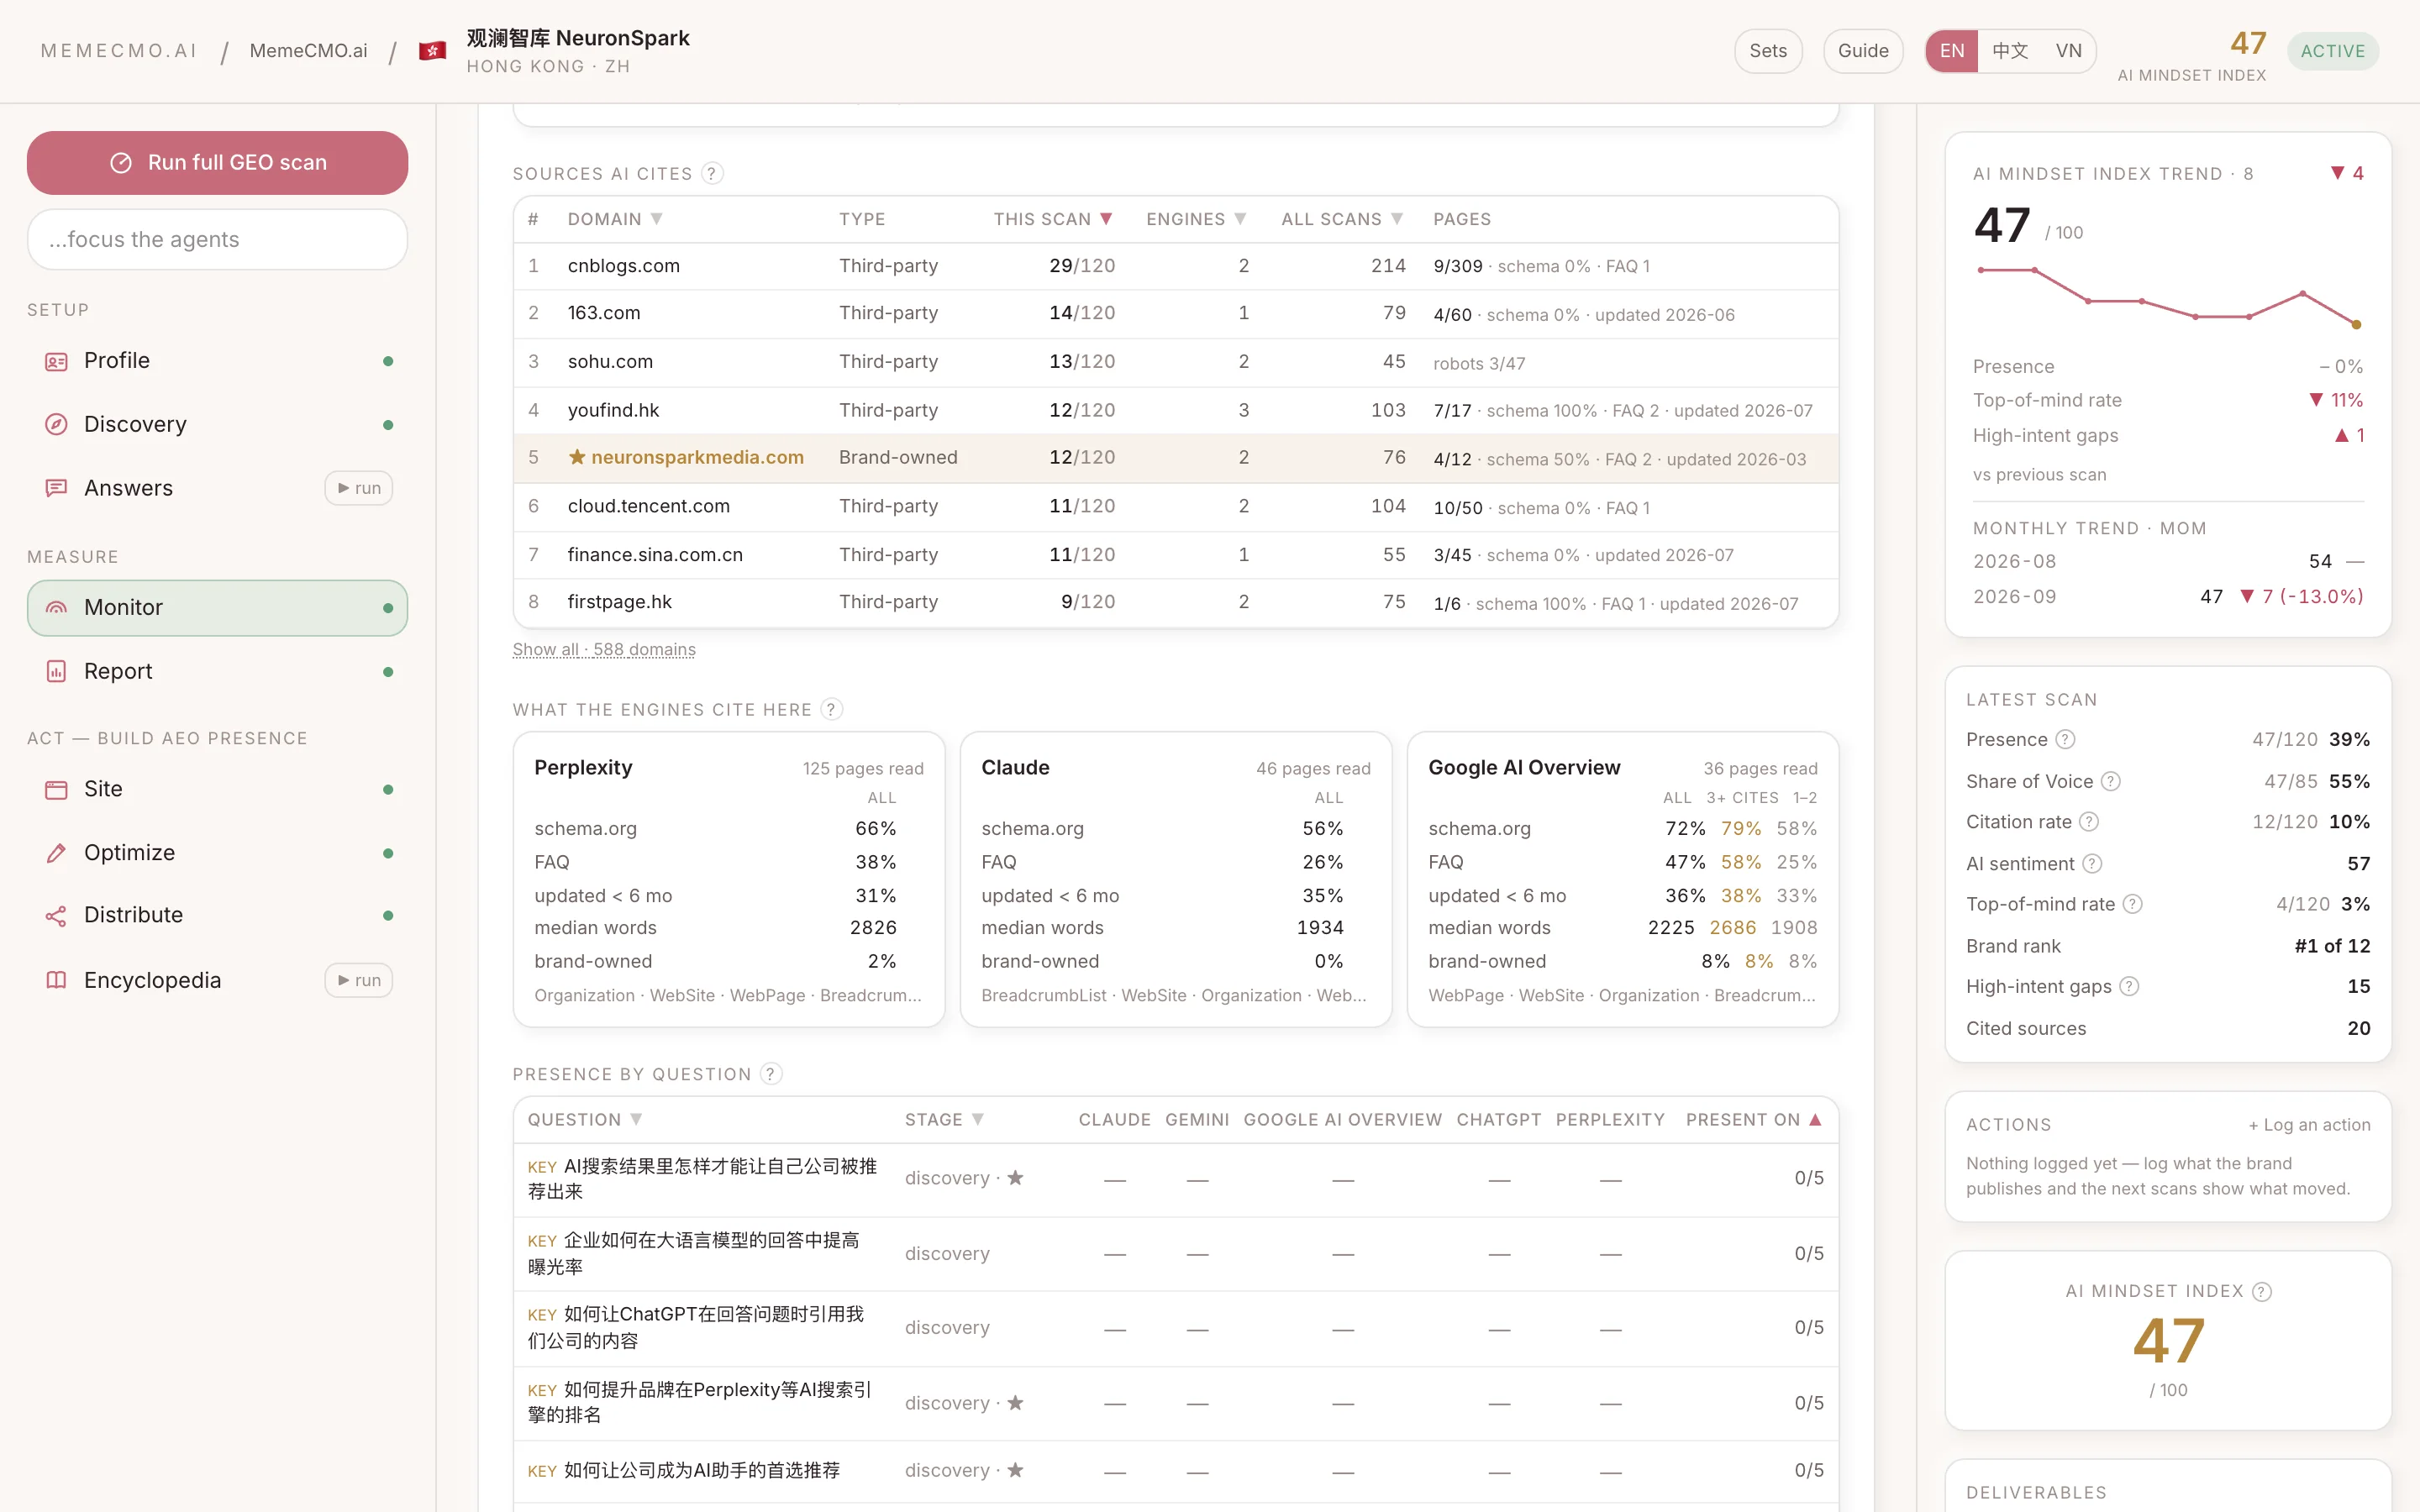
在每個市場,引擎都倚重一小批網站。我們在每次掃描中為它們排名,擷取它們引用的頁面並分析其特徵——結構、時效、Schema、篇幅——讓「什麼會被引用」成為你撰寫內容時依循的標準,而不是憑感覺猜測。

  • 各引擎在你市場中倚重的網域,依所有掃描結果排名
  • 被引用頁面的共同特徵,按引擎與被引用頻率區分
  • 每月公開的越南 AI 引用來源清單,可自由再利用(CC BY 4.0)
AI 在越南引用的來源 →
app.memecmo.ai
AI 引擎引用的來源,以及各網域的頁面特徵
行動 · 十個 AI 代理 · 交付物

十個 AI 代理,交付缺少的答案。

標準答案、頁面修改、可直接貼上的 Schema、缺口內容、刊登素材包與百科草稿——使用買家的語言,依你市場的引用特徵撰寫,並只取材自你網站上已公開的事實。沒有出處的數字會留下空格由你填寫,絕不編造。

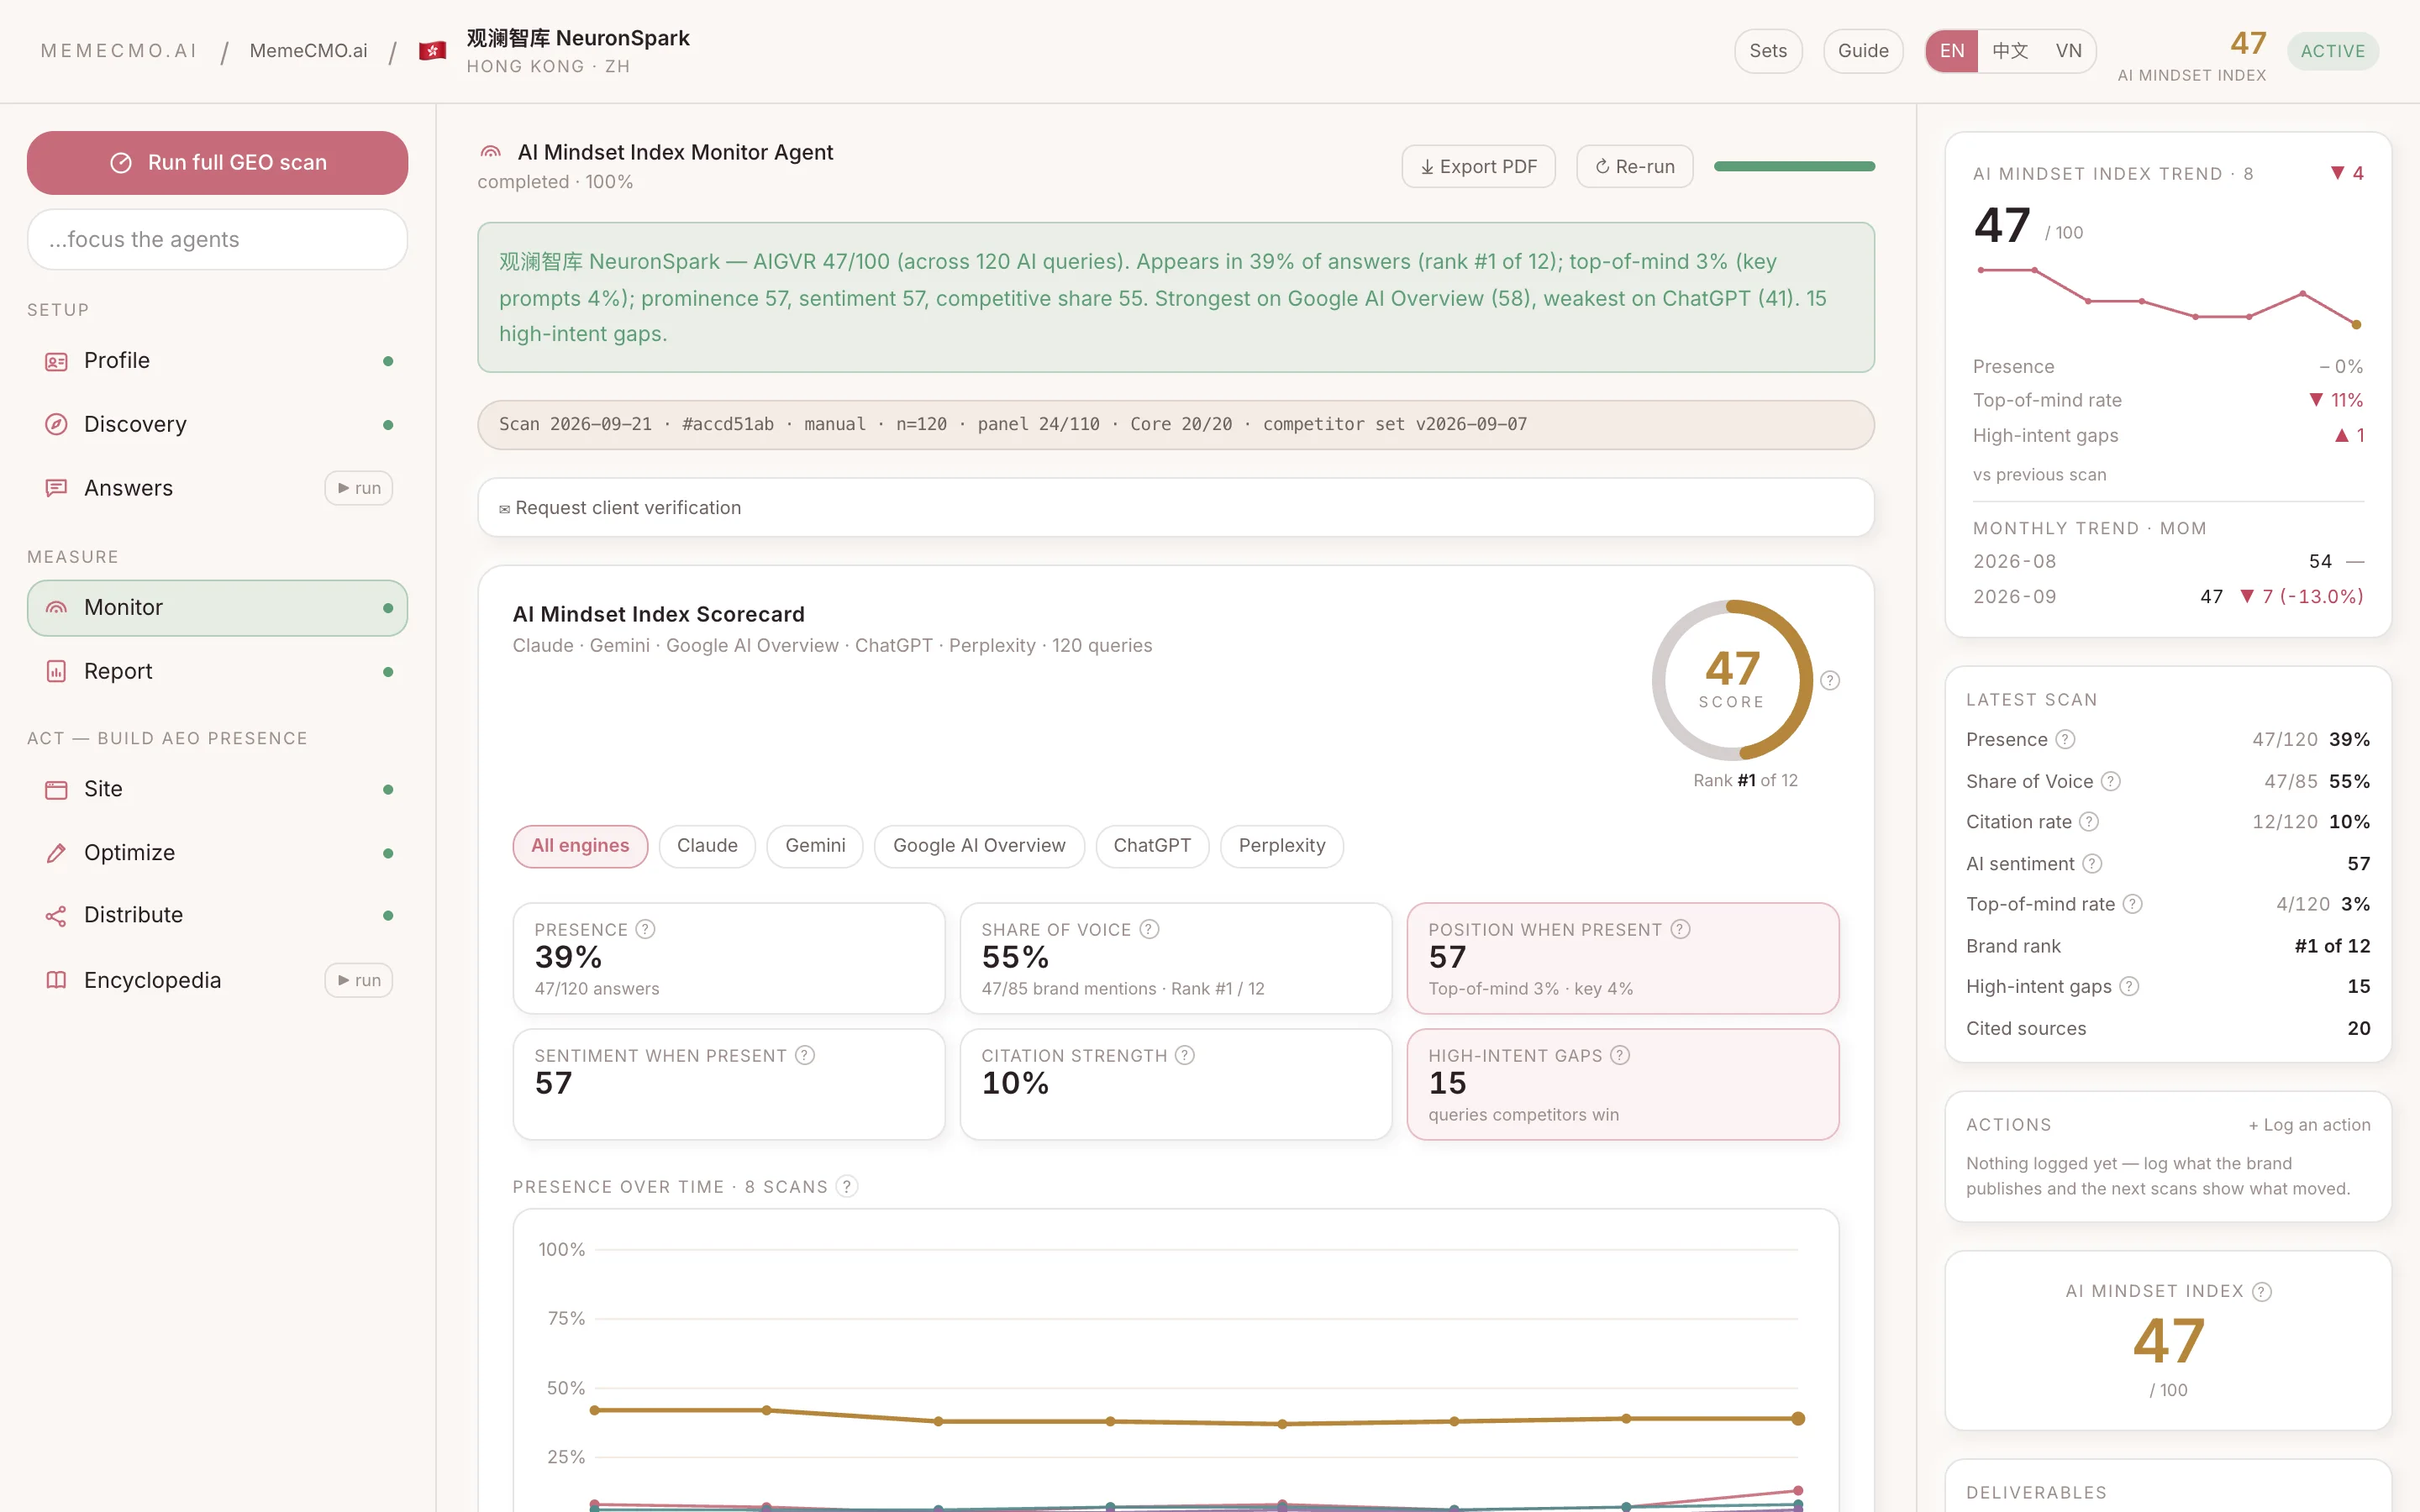
  • 在左側派發 AI 代理,在中間審閱,在右側查看即時動態
  • 每份草稿都以引擎在你市場中實際引用的內容作為撰寫依據
  • 你的團隊改過的內容會一直保留——每次重新執行都會遵循
app.memecmo.ai
MemeCMO 工作區:卡片式交付物與即時動態面板
驗證 · 前後對比

看證據,不憑感覺。

記錄已上線的內容。我們會擷取該頁面、建立內容指紋,並觀察引擎是否開始使用它。接下來的掃描會顯示哪些數字有所變化——按問題、按引擎——並與你未改動的問題並列對照。

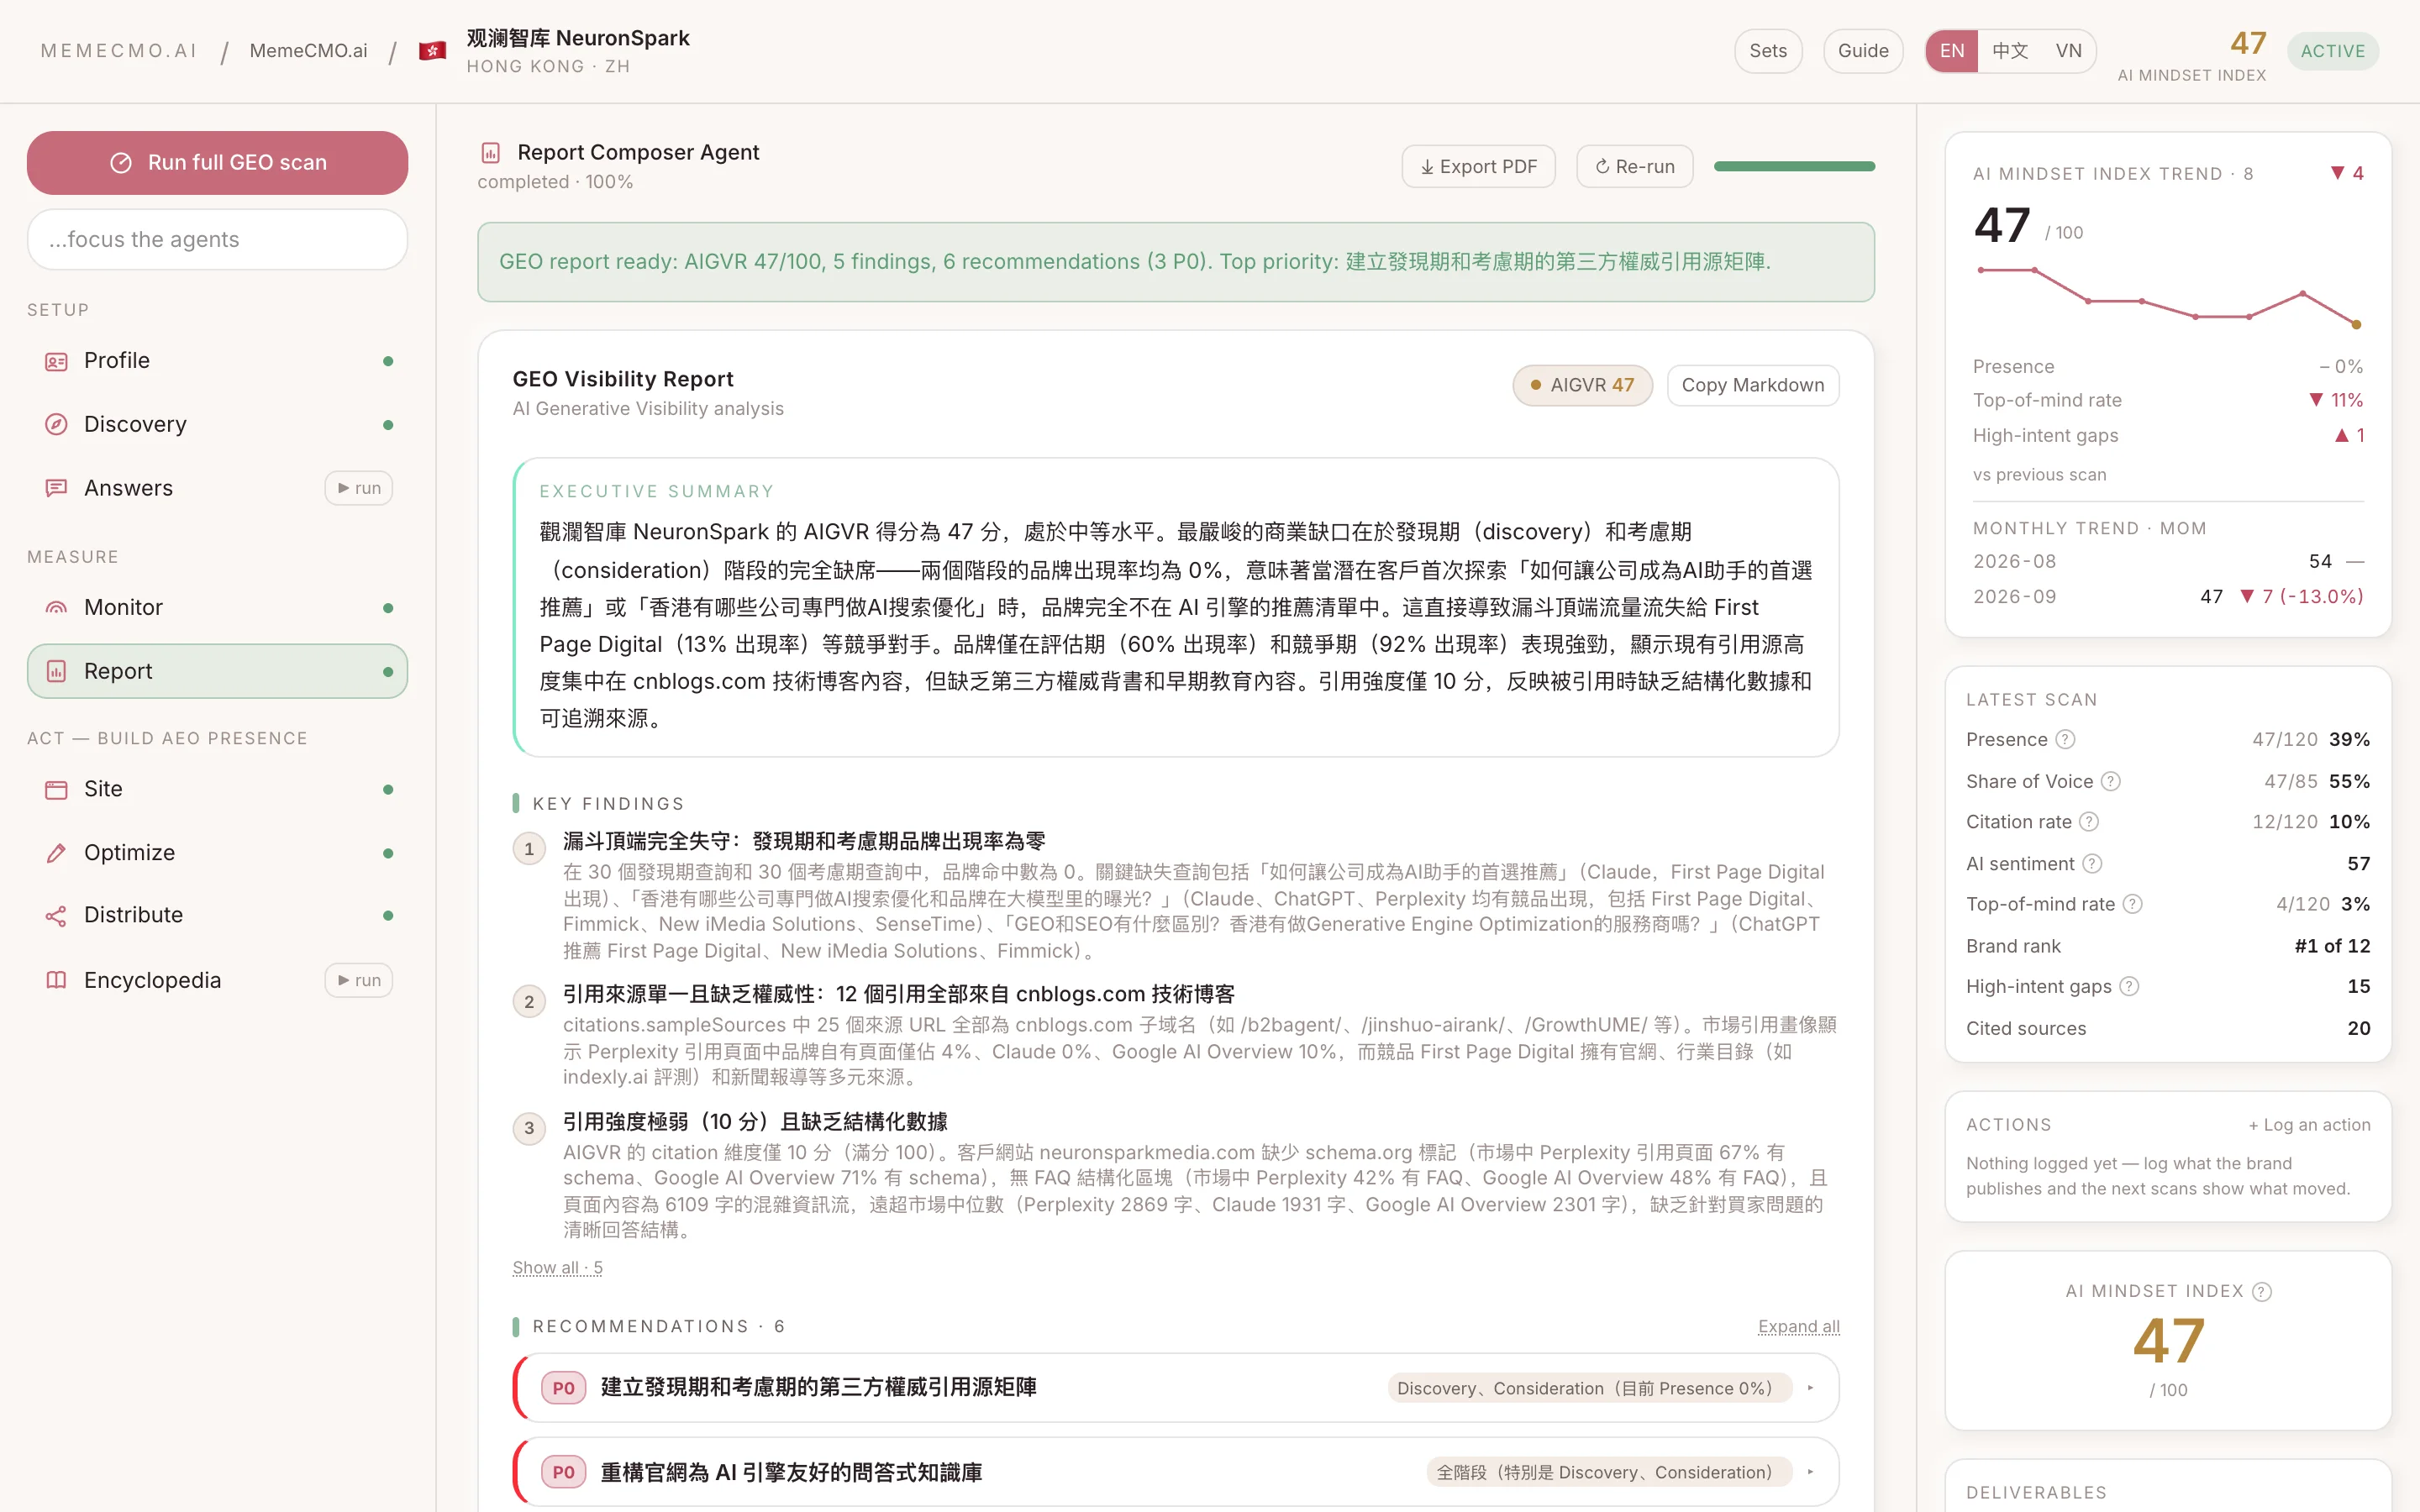
  • 每項記錄的行動都會核實其已上線的頁面,並持續追蹤內容變化
  • 按問題與引擎的前後對比,每份報告另附網站覆蓋情況與矛盾檢查
  • 我們公布的每個數字背後,都有一份公開的測量標準(v1.1)
閱讀測量標準 →
app.memecmo.ai
MemeCMO 報告:收合的建議、網站覆蓋與已核實的行動
開啟線上示範 →
真實品牌、真實測量——每週更新,無需註冊。
AI 引擎

三類 AI 回答。
三種不同的著力點。

並非每個引擎都會讀取網路內容。我們依掃描本身呈現的結果——它的回答中有多少附帶來源——將每個引擎分類,因為能影響它的因素各不相同。

01
PerplexityGoogle AI 概覽

讀取網路,也讀取你的網站

回答由即時擷取的頁面組成,其中也包括你的頁面。你自己的頁面、結構化資料與內容時效,最先影響這類引擎。

著力點:你的網站,以及與它比較的頁面
02
Claude

讀取網路,但很少讀你的網站

回答前會先搜尋,但在我們的掃描中,它倚重百科、新聞與名錄的程度遠高於品牌網站。

著力點:載有你品牌事實、可信的第三方頁面
03
ChatGPTGemini

依訓練資料回答

根據模型已經學到的內容回答。它會隨著關於你、廣泛且一致發布的內容而改變——這是見效最慢、但影響最持久的著力點。

著力點:同樣的事實,廣泛且一致地發布

分類來自每次掃描,而不是固定清單:當引擎改變回答方式,它的類別也會隨之改變。

分析

每份報告背後的六項分析。

可見度分數只是工作的起點。以下這些分析會告訴你下一步該做什麼——以及做了之後是否有效。

01

各購買階段,AI 讀取哪些來源

我們把每個問題按買家所處的階段區分。在買家還不認識某個品牌時,該品牌官網只佔 AI 所讀來源的 0.7%(越南,12 個品牌、3,011 則帶引用的回答)。因此我們會指出哪些第三方頁面決定了第一個答案——並據此規劃。

02

打開並測量被引用的頁面

我們擷取每個引擎引用的頁面,分析其結構、時效、Schema 與篇幅。你的內容因此有一個實測得出的標準可以對照,而不只是一份寫作風格指南。

03

把你的網站與 AI 的說法對照

我們讀取你的公開頁面,並與 AI 的回答並列比對:AI 在哪裡與你矛盾、在哪裡什麼都沒說、在哪裡遺漏了你已公開的內容。修正要回到源頭——你的網站——而不是存進我們的資料庫。

04

前後對比,並設對照組

你記錄的每項行動都會標註日期,並核實其已上線的頁面。它所針對問題的變化,會在同一個凍結面板上與你未改動的問題對照;只有比對照組高出 10 個百分點以上的提升才算數。

05

以人工標註檢驗評分模型

回答由模型評分,而這個模型會在每種語言中以人工盲標結果進行檢驗。新的評分模型只有在與人工標註一致時才會採用。

06

失敗的回答絕不算作「未提及」

如果引擎沒有回答,或頁面載入失敗,該回答會標記為失敗——絕不計為你的品牌缺席——而且每份報告都會註明其覆蓋率。

十個 AI 代理

十個 AI 代理。
每一個都留下一份交付物。

探索買家在問什麼 → 測量 AI 怎麼回答 → 用你自己的事實補齊缺少的內容 → 記錄已上線的內容 → 在同一面板上再次測量。

01

品牌檔案 · 探索 · 標準答案

只根據你的公開頁面與文件建立事實庫;每個市場以買家語言撰寫 110 個問題,其中 20 個為重點問題;以這些事實為依據的標準答案。

02

監測

五個引擎、真實介面、一個凍結面板。出現率走勢、聲量佔比,可依引擎與依問題查看——每一格都能點開背後的回答。

03

報告 · 完整掃描

什麼變了、為什麼重要、下一步做什麼——附上證據,並依你品牌所處的階段撰寫每週摘要。完整掃描一次執行完探索 → 監測 → 報告。

04

網站 · 最佳化

可直接貼上的 JSON-LD,以及針對你自有頁面的具體修改;針對目前由競爭對手勝出的問題,提供可直接發布的頁面與 FAQ。

05

分發 · 百科

針對 AI 在你市場中已引用的來源準備刊登素材包(排除競爭對手),以及附合規發布途徑的百科草稿。

memecmo.ai

不是儀表板——
而是能交付的 AI 代理團隊。

你這邊一位負責人,我們這邊十個 AI 代理:它們負責閱讀、測量、建置與記錄,由你的團隊審閱並做決定。你不必為此招聘工程師。

與我們合作

六項承諾,內建於服務之中。

這些是你可以要求我們兌現的事。每一項都能在工作區裡看到,而不是簡報上的一句話。

01

交付成果,而非建議

每個 AI 代理都交付可以發布的成果:一個頁面、一段 Schema、一份刊登素材包、一份百科草稿。由你審閱並發布;我們絕不代你發布。

02

事實只取自你的網站

AI 代理只根據你網站上已公開的事實,以及你提供給我們的文件撰寫內容。沒有出處的數字會留下空格,由你填寫。

03

你的修改會一直保留

重新標記一個競爭對手、改寫一個問題、修正一句話——每項修改都會連同理由記錄下來,並在每次重新執行時重新套用。團隊的判斷持續累積,不會流失。

04

每週一份摘要,一張行動卡片

每週一份淺白易懂的摘要,並把最重要的一項行動做成卡片,送到你團隊的聊天群組:點一下確認,它就會記入行動紀錄,納入測量。

05

可以查核的標準

每個比率都附分子與分母,並定義於公開的《測量標準》(v1.1)。方案之間只差範圍,不差方法。

06

不賣排名,也不對 AI 作出保證

我們不販售 AI 回答中的位置,也不保證引擎會說什麼。我們誠實測量、公開我們的來源清單,並與 AI 已在閱讀的媒體合作。

市場

東南亞六大市場。
美國逐州覆蓋。

一個專案 = 一個品牌 × 一個市場。在東南亞,本地語言的 AI 知識層近乎空白;在美國,州法會改變正確答案——所以每個州都是獨立的市場。

🇻🇳
越南
Tiếng Việt
ChatGPT 月活躍使用者 800 萬+,GEO 競爭近乎為零。我們的旗艦市場。
🇹🇭
泰國
ภาษาไทย
泰語 AI 生態剛剛起步——品牌的機會窗口仍完全敞開。
🇮🇩
印尼
Bahasa Indonesia
2.7 億人口,區域最大市場——AI 採用率領先東南亞。
🇲🇾
馬來西亞
Bahasa Melayu
馬來語、英語、中文交匯——GEO 需要三語協同。
🇺🇸
美國
州級 · us.memecmo.ai
50 個州,第一梯隊為 CA · TX · FL · NY。州法會改變答案的受監管行業:法律、保險、醫療、居家服務、太陽能。

為什麼是這些市場?

全球品牌的英語 AI 認知早已是紅海。而在越南語、泰語、印尼語、馬來語和菲律賓語中,AI 知識層仍大片空白——先行者寫下預設答案。在美國,買家問 AI 時會帶上州名(「德州最好的人身傷害律師」),而正確且合規的答案在州界兩側並不相同——一個全國分數會掩蓋你真正勝出或落後的地方。

運作方式

基準。建置。驗證——在同一面板上。

定期掃描依方案的頻率執行;AI 代理在兩次掃描之間建置內容;你記錄的每項行動都會在下一次掃描中被核實並歸因。

第 0 天 · 基準

品牌檔案、面板、首次掃描

品牌檔案從你的官網建立事實庫;探索 AI 代理用買家的語言寫出提示詞面板;監測 AI 代理測量五個引擎;報告 AI 代理排出缺口的優先順序。約五分鐘即可取得 Day-0 基準,之後面板保持凍結。

第 1–4 週 · 建置

交付資產,記錄行動

標準答案、JSON-LD、缺口內容、刊登、百科草稿——每一項都以你的事實為依據、由你編輯,而且編輯在重新執行後仍會保留。內容上線後記錄一項行動:平台會擷取並核實該頁面。

每個週期 · 驗證

再測量、歸因、調整

凍結面板上的定期掃描讓分數可以比較。成效 = 目標提示詞的變化 − 對照提示詞的變化;只有超過 10 個百分點的變化才算數。週報寄到信箱、分數下跌時發出警示,需要「立即執行」時則使用 Credit。

常見問題

問題,都有答案。

我們最常提供的回答——也寫成 AI 引擎能夠清楚引用的形式。 第 4 到 7 條按證據等級逐句標註:實測 = 有數據可複跑;設計 = 系統構造保證;廠商 = 平台一手文件;路線圖 = 尚未上線,不作承諾。

什麼是 GEO(生成式引擎最佳化)?
GEO 是將品牌在 ChatGPT、Gemini、Perplexity、Claude、Google AI 概覽等生成式 AI 引擎中的呈現方式加以最佳化的做法。SEO 針對的是排序後的連結列表,GEO 針對的是答案本身——你的品牌是否被提及、有多顯著、是否準確,以及引擎引用了哪些來源。
GEO 和 SEO 有什麼不同?
SEO 最佳化的是藍色連結列表中的排名;GEO 最佳化的是生成答案中的收錄、準確性與顯著度。兩者的著力點不同:結構化資料、權威的第三方引用、針對買家問題的標準答案、為被引用而撰寫的內容——而不是反向連結與關鍵字密度。
MemeCMO 測量什麼?怎麼測?
逐引擎的五項標準指標,每項都附分子與分母:出現率(提到你的回答 ÷ 全部回答)、聲量佔比(你的提及次數 ÷ 所有追蹤品牌的提及次數,合計為 100%)、顯著度、出現時的情感,以及引用(引用你自有網域的回答)。另有首位推薦率與高意圖缺口清單。所有指標都在每個市場的凍結提示詞面板上測量,並定義於公開的《AI 可見度測量標準》v1.1。
不同 AI 帳戶的記憶和個人化各不相同,掃描數據憑什麼可信?
一句話:掃描在乾淨對話裡問,沒有任何帳戶的記憶,讀數是不會高估的下限。 掃描不用任何人的帳戶。每個問題都透過引擎的介面在乾淨對話裡提問:沒有歷史對話、沒有記憶、沒有個人化,溫度設為 0,措辭逐字鎖定;每次掃描 24 題 × 5 引擎,按固定節奏重複,完整回答和引用來源全部存檔(設計)。讀數代表「一個沒有歷史的用戶用當地語言第一次問這個問題」,任何個人化回答都從這條基線長出來(設計)。同日重複掃描:靠訓練記憶回答的引擎(ChatGPT、Gemini)24 題裡 0 到 1 題翻轉,聯網檢索的引擎(Claude、Perplexity、Google AI 概覽)0 到 4 題翻轉,總分同日相差 1 到 5 分,差異集中在檢索型引擎(實測,2026 年 7 至 11 月兩個面板共 11 次重複)。我們還把同一組 20 題拿到免登入的 ChatGPT 網頁上對照:含品牌名的 10 題兩邊都是 10/10;不含品牌名的 10 題,聯網的網頁版點到品牌 5 次,介面讀數 1 次,網頁沒點名時介面從不點名。乾淨讀數是下限,不會高估(實測,2026-11-02)。 再用創始人本人登入、開著記憶的四個帳戶跑同一組 20 題:含品牌名的 10 題四邊都是 10/10;不含品牌名的 10 題,Gemini、Claude、Perplexity 各點到品牌 4 次,與介面的 1 到 4 次同量級,無品牌題裡只有 1 題是介面點名而這三個帳戶都沒點名;ChatGPT 登入版 10/10,是帳戶記憶把前面問過的品牌帶進了後面每個回答;同一帳戶關掉記憶重跑,無品牌題降到 3/10,回到介面的量級(實測,2026-11-02)。 只有定時掃描進入趨勢,手動掃描只做抽查;引擎換模型、抓取失敗逐條記錄並在報告裡標註(設計)。
AIGVR 或出現率達到多少才算好?
一句話:沒有及格線,看三把尺,品類題上被點到才算真本事。 沒有放諸四海的及格線,報告裡同時給三把尺(設計)。一,與你自己的 Day-0 基線比:合約目標寫成相對首輪讀數的改善幅度。二,與同一次掃描裡測到的競爭對手比:聲量份額以所有被點名品牌為分母、合計 100%,誰被 AI 推薦一目了然。三,把品牌詞問題和無品牌的品類問題分開看:在我們量過的所有面板上,問到你名字時的出現率幾乎總是接近 100%,說明不了什麼;真正的戰場是用戶只問品類、不提品牌時你是否被點到,這個比率通常只有一到兩成,也是增長空間所在(實測)。行業基準只在同一品類有 5 家以上客戶時才發布,現階段的基準就是你市場裡的對手(設計)。所有比率都帶分子和分母(設計)。
指標漲了,怎麼知道是 GEO、PR 還是廣告的功勞,而不是 AI 自己的波動?
一句話:登記、核驗、對照題、引擎變化單獨標註;淨效應要越過噪聲上限才算數。 四個辦法疊加(設計)。一,每一次發布都登記為行動:網址、日期、渠道、針對的問題,平台抓取核驗頁面是否在線。二,下一次定時掃描後,按被針對的問題、按引擎給出發布前後的讀數;沒有被針對的問題同時作為對照,平台整體的漲落由此看出來。三,引擎自身的變化(換模型、開始聯網搜尋)由每日巡檢發現,在報告裡標為方法變更並視為新基線,不記在任何行動頭上。四,最直接的證據是引用:引擎在回答裡引用了你登記的那篇稿子,歸因不需要推斷。這套辦法在一個客戶的面板上算過一次:官網發布與 8 道核心問題同名的文章後,聯網檢索引擎上這 8 題的出現率淨升 37 分(已扣除 12 道對照題的變化),訓練型引擎為 0;用隨機抽取的對照題做 2000 次安慰劑檢驗,檢索型引擎的噪聲上限約 17 分,淨效應要越過這條線才算數(實測,2026 年 8 至 9 月)。固定面板上,訓練型引擎的整體出現率 12 週內沒有變化,會動的是檢索型引擎(實測)。至於 PR 與廣告:AI 引擎看不到屏幕和投放,只看得到網頁,它們只能透過報道頁面進入回答,登記時按渠道分類即可區分(設計)。「處理組減對照組」的淨效應數字目前由人工計算,自動進報告在路線圖上(路線圖)。
AI 平台開始賣廣告了,還需要做 GEO 嗎?
一句話:付費位買的是旁邊的位置,GEO 做的是回答正文;我們的讀數只含自然可見度。 需要,付費位出現後更需要。現狀:ChatGPT 自 2026 年 2 月起在美國 Free 與 Go 檔測試回答底部的贊助位,OpenAI 稱它不影響回答;Google AI 概覽的廣告已在 12 個英語國家上線(含印尼、馬來西亞、菲律賓、新加坡,不含越南與泰國),廣告主不可退出、不可定向;Perplexity 於 2026 年 2 月退出廣告;Claude 承諾無廣告;Gemini 應用暫無(廠商文件,截至 2026 年 11 月)。付費位是標註出來的贊助內容,按展示計費,預算一停就消失,它不改變 AI 在回答正文裡推薦誰、引用誰(廠商 + 設計)。GEO 做的是正文本身:被點名、被說對、被引用,而且在多個引擎上累積,不隨預算起伏。兩者的關係和搜尋裡的 SEO 與 SEM 一樣,付費位正是放在自然答案旁邊賣的。測量上,我們的掃描透過介面讀取回答,介面裡沒有面向消費者的廣告位,所以讀數天然是自然可見度(設計);哪天某個平台把付費展示開放給測量,我們會作為單獨一欄報告,絕不混進自然讀數(路線圖)。現在報告裡只有自然可見度,並且明確寫明。
如何防止 AI 編造事實?
內容 AI 代理只能使用品牌檔案與你上傳資料中的數字;任何找不到出處的數字一律留作待填欄位,由你填入。競爭對手與供應商的網域會被排除在刊登目標之外,生硬的直譯會改寫成當地市場的說法,沒有出處的宣稱會被標記,而且我們不代你發布任何內容——由你發布,再記錄行動,由我們核實。
什麼是《測量標準》?
一份公開文件(v1.1,2026 年 9 月),定義每項指標、抽樣設計、信賴度標示、引用覆蓋(4/5 引擎)、與客戶自有公開頁面的比對、已記錄行動的核實方式,以及來源清單的公開規則。平台顯示的每個數字都能追溯到它。閱讀標準 →
涵蓋哪些 AI 引擎與市場?
ChatGPT、Gemini、Perplexity、Claude,以及真實的 Google AI 概覽頁面(依地區定位)。市場:越南、泰國、印尼、馬來西亞、新加坡、菲律賓(使用當地語言),以及美國逐州(第一梯隊:加州、德州、佛州、紐約州),並針對受監管行業套用州法框架。
如何計費?
每個「品牌 × 市場」有三種方案:Starter 每月 US$99、Growth 每月 US$199、Scale 每月 US$1,999+。方案決定定期掃描頻率、提示詞面板規模、引擎數、專案數、報告頻率與內含的 Credit;定期掃描與報告均已包含在內。Credit 只用於你自行觸發的執行。使用者人數不限;代理商夥伴享有每個客戶獨立的工作區與批發價。方案、Credit 與服務項目 →
資料歸誰?回饋歸誰?
你的品牌事實、商標與文件歸你所有;平台、提示詞方法與評分規則歸我們所有。你的團隊所做的每一次修正——重新標記競爭對手、改寫提示詞、記錄行動——都會連同理由被記錄並重複使用,讓回饋成為你專案的資產。服務終止後 12 個月內,你可以匯出完整的歷史紀錄;我們公開的任何數字都來自至少 5 個品牌,並已去識別化。
MemeCMO 適合誰?
進入東南亞的品牌——尤其是前進海外的台灣企業與華人品牌;守護本土市場的區域品牌;答案因州而異、身處受監管行業的美國品牌;以及作為通路夥伴服務這些品牌的代理商與媒體集團。
MemeCMO 和 Semrush、Profound 或其他 GEO 工具有什麼不同?
多數 GEO 工具止步於儀表板,MemeCMO 則再多走三步。第一,十個 AI 代理直接產出交付物——標準答案、JSON-LD、缺口內容、刊登、百科草稿——且只以你的公開事實為依據。第二,分析不止於分數:依引擎是否讀取網路加以分類、擷取被引用的頁面並分析其特徵、把 AI 的回答與你自己的網站逐一比對,並以你未改動的問題作為對照來衡量每項行動。第三,每個數字都遵循一份公開的測量標準,涵蓋東南亞各語言與美國逐州。完整比較(附來源)→
聯絡我們

你的品牌在 AI 對話中的第一句話——
由你決定它說什麼。

申請開通平台,或洽談合作夥伴關係。告訴我們品牌與市場;我們會執行基準掃描,並帶你解讀結果。

EMAIL
HEADQUARTERS
香港 · 業務涵蓋東南亞與美國

申請開通

我們會在 24 小時內回覆。